
Überarbeitet am 15. September 2026.
Eine Antwort über offene Rechnungen ist nur dann brauchbar, wenn Betrag, Kunde und Zahlungsstatus zusammenpassen. Eine Quellenangabe erleichtert die Prüfung, beweist diese Zuordnung aber noch nicht. Mit Souprise verfolge ich deshalb einen begrenzten Ansatz: Geschäftsdaten lokal erschließen, Werte aus den Datensätzen übernehmen und Berechnungen im Code ausführen. Die veröffentlichten Entwicklungsberichte dokumentieren 60 korrekte Einzelabfragen und 40 korrekte Aggregationen in ihren jeweiligen Tests. Diese Ergebnisse stammen aus vorgegebenen Szenarien mit synthetischen Daten und sind keine allgemeine Korrektheitsgarantie. Einzelabfragen, Aggregationen
Trennung von Datenabfrage und Formulierung
Souprise ist ein Open-Source-Projekt für strukturierte Geschäftsdaten, etwa Rechnungen, Aufträge und Kundenstammdaten. Im Standardmodus verified ordnen Regeln die Frage einem Datensatz und einem Feld zu. Der Antwortwert wird aus dem gefundenen Datensatz übernommen, ohne dafür ein Sprachmodell einzusetzen. Für erkannte Summen- und Durchschnittsfragen berechnet ein eigener Programmteil das Ergebnis mit Dezimalarithmetik. Die unterstützten Felder und Filter begrenzen, welche Fragen dieser Weg beantworten kann. Projektbeschreibung, Berechnungsverfahren
Bei widersprüchlichen Werten soll die Antwort die gefundenen Kandidaten offenlegen. Bei unbekannten Entitäten oder unzureichenden Treffern ist eine Ablehnung vorgesehen. Auch diese Entscheidungen hängen von der Erkennung der Frage und der Auswahl der Datensätze ab. Wird kein bestimmtes Feld erkannt, kann die Ausgabe stattdessen den gefundenen Datensatz enthalten. Das ist eine nachvollziehbare Suchhilfe, aber noch keine Bestätigung, dass die ursprüngliche Frage beantwortet wurde. Verfahren und Grenzen des Standardmodus
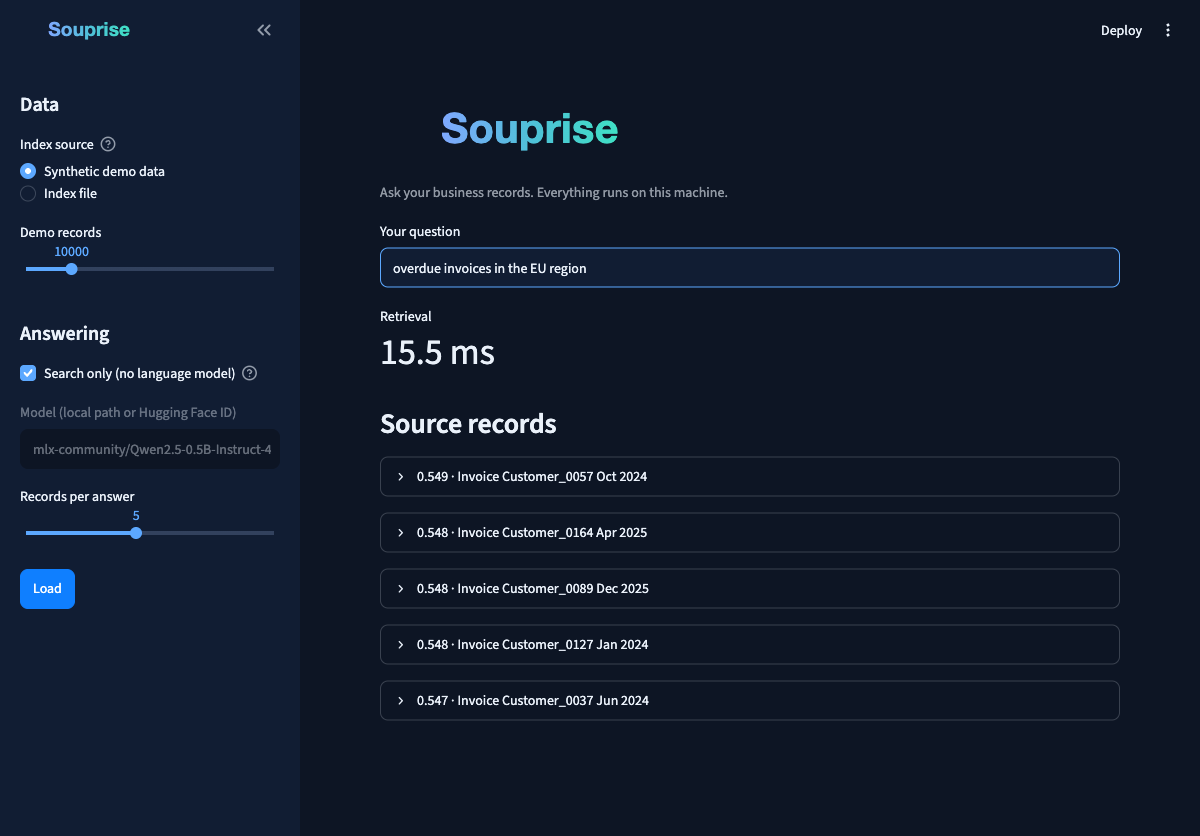
Die lokale Verarbeitung ist ein wesentliches Gestaltungsziel. Der Standardmodus benötigt kein Sprachmodell. Für die optionalen Sprachmodi lässt sich ein bereits lokal vorhandenes Modell verwenden, während der Schnellstart andernfalls zunächst ein Modell herunterlädt. Bei eigenen Erweiterungen müssen deren Datenflüsse gesondert geprüft werden. Aus der lokalen Ausführung allein folgt noch kein vollständiges Sicherheitskonzept. Betriebsvarianten
Aussagekraft der veröffentlichten Tests
Im Bericht BENCH-5 stimmen die ausgegebenen Werte bei 60 Einzelabfragen auf einem um Dubletten bereinigten Datenbestand mit den erwarteten Werten überein. Der Bericht nennt außerdem 20 unbekannte Entitäten, deren Abfragen nach einer Korrektur der Erkennung abgelehnt wurden. Die erste Fassung hatte diesen Test nicht bestanden, weil sie den ähnlichsten vorhandenen Treffer zurückgab. Das dokumentierte Ergebnis beschreibt damit einen konkret geprüften Entwicklungsstand und zeigt zugleich, weshalb Ähnlichkeit allein für solche Abfragen nicht genügt. BENCH-5
Für Aggregationen verzeichnet BENCH-6 Übereinstimmung mit einer unabhängigen Referenzrechnung in 40 Fällen. Im selben Bericht wird der Modus styled an 80 Fragen geprüft. Dabei formuliert ein lokales Modell die zuvor ermittelten Werte aus, und eine Zahlenprüfung soll Abweichungen erkennen. Im beschriebenen Lauf bei Temperatur 0 trat keine beanstandete Abweichung auf, weshalb der Rückfall auf die deterministische Antwort kein einziges Mal ausgelöst wurde. Dieser Lauf belegt daher nicht, dass die Prüfung jede fehlerhafte Modellantwort abfangen würde. BENCH-6
Auch das zusätzliche Modelltraining brachte im veröffentlichten Vergleich keinen nachgewiesenen Vorteil. Bei 60 Fragen über 2.000 synthetische Datensätze erreichte das unveränderte Modell eine Trefferquote von 0,733, die trainierte Variante 0,717. Der Bericht wertet die geringe Differenz bei diesem Stichprobenumfang nicht als belastbaren Nachteil des Trainings. Für diese Aufgabe rechtfertigte der Versuch den zusätzlichen Trainingsaufwand nicht. Fine-Tuning-Vergleich
Grenzen der Zahlenprüfung
Die Implementierung setzt dem Anspruch einer lückenlosen Prüfung eine konkrete Grenze. Die Funktion _extract_numbers berücksichtigt im hier geprüften Quellstand Zahlen ab 100 sowie Zahlen mit Dezimalpunkt. Positive ganze Zahlen unter 100 und negative ganze Zahlen werden von dieser Funktion nicht erfasst. Außerdem prüft der Abgleich das Vorkommen der erfassten Zahlen in den Vergleichstexten. Er beweist nicht, dass ein Betrag zum richtigen Kunden gehört oder dass der übrige Satz fachlich stimmt. Eine allgemeine Aussage wie „jede Zahl wird geprüft“ wäre deshalb falsch. Implementierung der Zahlenprüfung
Hinzu kommt die Qualität des Datenbestands. Ein veralteter Zahlungsstatus bleibt veraltet, wenn er korrekt aus dem Index übernommen wird. Für eine Summe muss außerdem feststehen, welche Datensätze einbezogen wurden und ob Angaben fehlen. Quellen, Aktualisierungsregeln und nachvollziehbare Berechnungen erleichtern die Kontrolle. Sie ersetzen die fachliche Prüfung der Daten nicht.
Voraussetzungen für den Betrieb
Die Entwicklungsberichte enthalten auch Tests zu Berechtigungen und zur Trennung von Mandanten. BENCH-9 meldet bei 200 Abfragen unter einer bestimmten Berechtigungsregel keine erkannten unzulässigen Ausgaben. BENCH-10 dokumentiert dasselbe für 200 Abfragen über zwei getrennte Mandantenbestände mit jeweils 1.000 synthetischen Datensätzen. Diese Ergebnisse gelten für die geprüften Szenarien. Sie ersetzen keine Prüfung von Benutzeranmeldung, Betriebssystemrechten, geänderten Datenbeständen und eigenen Erweiterungen. Berechtigungstest, Mandantentest
Die Berichte benennen diese Grenze selbst. Berechtigungsregeln sind Objekte innerhalb des laufenden Programms, während die Zuordnung eines angemeldeten Benutzers zu seinen Rechten gesondert gelöst werden muss. Getrennte Dateien unter demselben Betriebssystemkonto sind keine vollständige Abschottung gegeneinander. Ein lokaler Pilot braucht deshalb einen klaren Datenumfang und eine definierte Betriebsverantwortung. Aus bestandenen Entwicklungstests lässt sich keine Freigabe für beliebige Unternehmensumgebungen ableiten.
Wirtschaftliche Einordnung
Der mögliche Nutzen liegt in kürzeren Suchwegen und einer nachvollziehbaren Verbindung zwischen Antwort und Datenbestand. Ob das im Unternehmen Zeit spart, hängt vom Aufwand für Datenaufbereitung, Aktualisierung und Prüfung ab. Eine lokale Installation vermeidet nicht die Kosten für Betrieb, Wartung und fachliche Betreuung. Ein sinnvoller Pilot vergleicht deshalb einen abgegrenzten Arbeitsvorgang mit dem bestehenden Verfahren und erfasst auch Korrekturen und Nacharbeit.
Souprise stellt dafür Quellcode, Testberichte und einen überprüfbaren Ansatz bereit. Die veröffentlichten Ergebnisse begründen eine gezielte Erprobung, wenn die Aufgabe zu den unterstützten Daten und Abfragen passt. Entscheidend ist, ob die Antworten im eigenen Prozess verlässlich geprüft und verwendet werden können.